こんにちは、ミツモアの@teradonburiです。 ミツモアのモノレポのテストを、jestからvitestに全部移行しました。フロントエンドもバックエンドも、モノレポ内の複数アプリまとめてです(テストファイルが約1,500、テストケースは1万件超)。 結果だけ先に言うと、テスト時間も料金もメモリも、どれも約20%以上下がりました。
以下、前提とテスト構成、なぜ並列vitestにしたか、移行時のハマりポイント、並列化インフラのコスパ最適化、CI全体の最適化、の順に書いていきます。
前提: 使っている技術
記事に出てくるものを先に並べておきます。話の軸はNestJSのDIとtestcontainersです。
- Node.js + NestJS: バックエンドのフレームワークです。DI(Dependency Injection、依存性の注入)のコンテナを持っていて、providerをinjection token(インジェクショントークン)で識別して注入します。あとで出てくる「injection tokenが一致しない」は、この仕組みで注入先が見つからなくなる話です。
- jest: JavaScript/TypeScript向けの定番テストフレームワークです。移行前に使っていました。
- vitest: Viteベースのテストフレームワークです。変換にSWC、実行にViteのSSRを使います。今回の移行先です。
- SWC: TypeScript/JavaScriptの高速なコンパイラ(TS→JS変換)です。APIサーバのビルドに使っています。
- testcontainers: テストのたびにDockerで本物のMongoDBやPostgreSQLを立ち上げて、それに対してテストするライブラリです。モックではなく実物を使うので、並列にするとワーカー間でコンテナの取り合いが起きます。並列化の罠の多くはここ由来です。
- MongoDB(Mongoose): メインのDBです。
- PostgreSQL(Prisma): 一部のサービスで使っているDBです。
- zod: スキーマバリデーションのライブラリです。
- React: フロントエンド、こちらのテストも今回の移行対象です。
- GitHub Actions: CIを動かすプラットフォームです。テストや型チェックをジョブ単位で実行し、ジョブ間の依存(
needs)や並列実行を制御します。runnerはセルフホスト(EC2、arm系。4/8/16 vCPUを使い分け)です。
テスト構成: shardとworker
先に用語を整理します。テストの並列化は二段構えです。
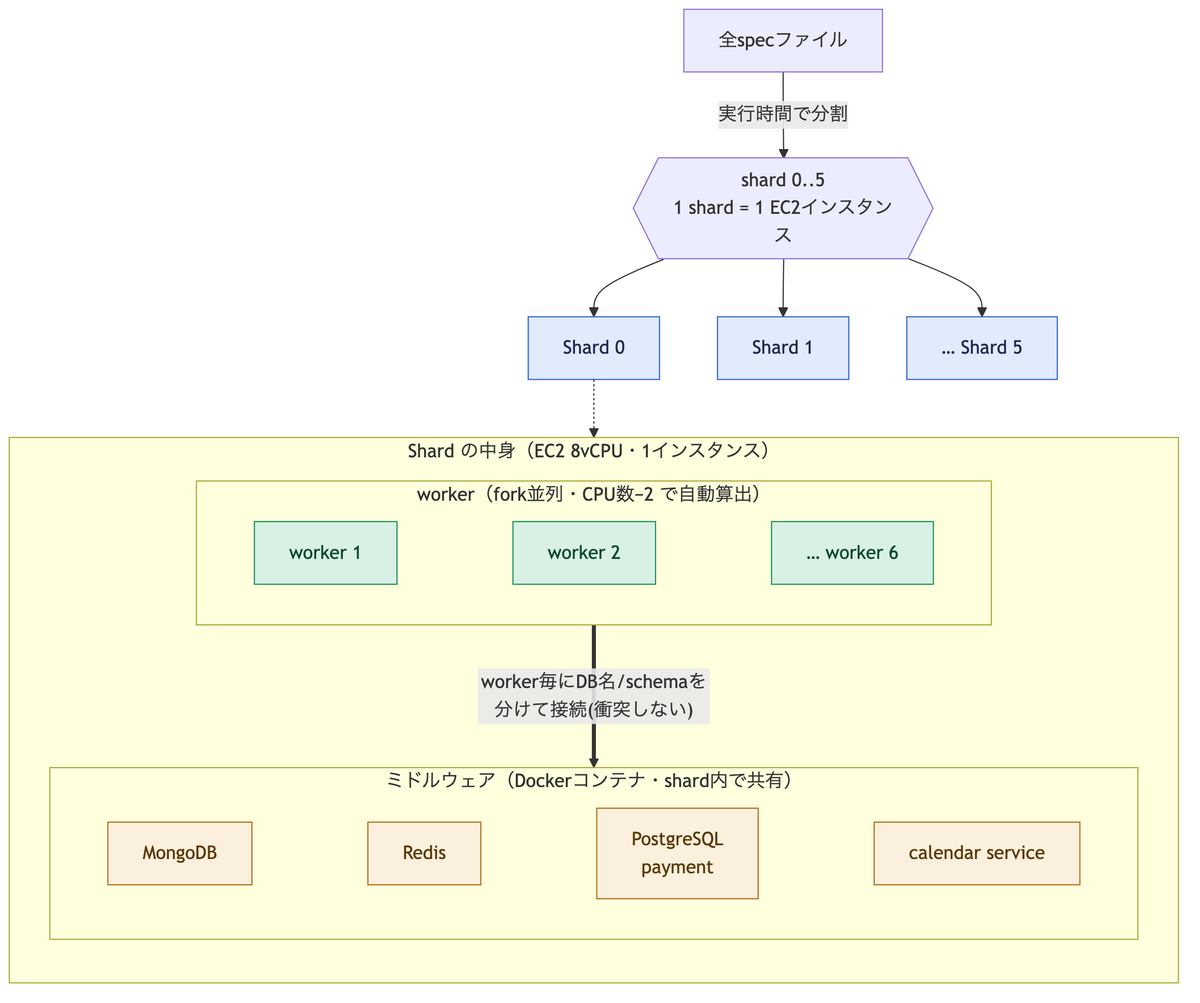
- shard: 全specファイルを実行時間ベースでいくつかに分割し、1つのshardを1台のEC2インスタンスで走らせます。インスタンス単位の分割です。
- worker: 1つのshardの中で、specを複数のワーカー(fork)に分けて並列に実行します。インスタンス内での分割です。
ワーカーはMongoDB・Redis・カレンダーサービス・payment(PostgreSQL)といったミドルウェアを共有しますが、DB名やスキーマをワーカー単位で分けて衝突を防いでいます(詳しくは後述の「並列化に伴うインフラ構成」)。全体像は下図のとおりです。
TL;DR
移行前(直列jest)と、採用したvitest並列構成の最終結果です。
| jest 直列(移行前) | vitest 並列(採用) | |
|---|---|---|
| 構成 | 4vCPU・1ワーカー・12shard | 8vCPU・6ワーカー・6shard |
| CI時間(shard平均) | 526秒 | 428秒(−19%) |
| 料金/run | 約$0.20 | 約$0.16(−20%) |
- 速度: vitest並列化して、移行前のjestより速くしました。CI時間で−19%(526秒 → 428秒)。
- メモリ: 同じ8vCPU機・6ワーカーで比べると、jestは28.8GiB使ってOOMで落ちるのに対し、vitestは12.3GiB。約2.3倍のメモリ効率で、余裕がある分ワーカーを積めて並列でスケールします。
- 料金: セルフホストCIは実行時間がそのままコストです。移行前の直列jestの約$0.20から、採用構成の約$0.16に下がりました。
なぜ並列vitestにしたか
テストランナーの選定の話です。結論は並列vitestですが、なぜそう決めたのかを、まずテスト時間の内訳から見ていきます。
テストにかかる時間は、CIの立ち上げ、依存インストール、ランナーのセットアップ、トランスパイル、テスト本体の実行に分かれます。ミツモアのバックエンドで実測すると、支配的なのはテスト本体ではなくモジュール評価(import)で約7割、テスト本体(.spec)の実行は約1割でした。アプリのモジュール依存グラフが大きいので、テストを動かす前の読み込みと評価が一番重いわけです。勝負を分けるのは、この重いモジュール評価をどう捌くか。直列での速さと、並列でのスケール、順に見ます。
直列: lazy-requireを失って負ける
vitestに移して最初に直列で回したとき、jestより遅くなりました。がっかりしましたが、理由ははっきりしています。ビルド後の実行モデルの違いです。
| jest(移行前) | vitest(移行後) | |
|---|---|---|
| 変換後の形式 | CommonJS(babel/ts-jest の require) |
ES Module(SWC + Vite SSR) |
| モジュール評価 | require() は同期。呼ばれた時点で評価(遅延できる) |
依存グラフを先に評価する(eager) |
| 変換キャッシュ | ディスクに残る(2回目以降は変換をスキップ) | 残らない(毎回変換する) |
jest時代は遅延requireで評価を抑えていました。ふつうrequire(x)のような静的なロードは、ファイルを読み込んだ時点でそのモジュールをまるごと評価します。これを、初めて実際に参照されるまで評価しないように書き換える仕組みです。静的なimportを、import()(dynamic import)のような実行時の遅延評価に変換するイメージが近いです。この遅延のおかげで、重いモジュール評価を、実際に使う分だけに抑えられていました。
使っていたのはOSSの babel-plugin-lazy-require です。
vitestではこれが使えません。理由は3つあります。
まず、変換がBabelを通りません。このプラグインはBabelの変換チェーンでrequireを書き換えるものなので、SWCとVite SSRの経路には乗りません。プラグインごと消えます。
次に、lazy-requireという手法自体がCommonJS前提です。requireが同期でいつでも呼べることに乗っかっています。ESMはlink/evaluationの時点で束縛が決まりますし、Vite SSRの内部import(__vite_ssr_import__)も依存を先にawaitします。評価を初回のプロパティアクセスまで遅らせるフックがありません。SWC向けに移植しても、ESMでは同じ遅延はできません。
最後に、元になるOSS自体がもうメンテされていません。babel-plugin-lazy-requireは最終コミットが2018年で、更新が止まっています。SWC/ESM向けに作り直そうにも頼れる本家がなく、この遅延ロードの仕組みを自前でゼロから抱えることになります。そこまでの手間はかけられませんでした。
要するに、移行と引き換えに遅延評価によるコスト圧縮を失いました。モジュール評価を全部前もって走らせることになり、直列だと遅くなります。数字にするとこうです。
| 構成 | vCPU × worker | shard平均 | 備考 |
|---|---|---|---|
| jest 直列 | 4 × 1 | 526s | 基準(参考値) |
| vitest 直列 | 4 × 1 | 約760s | jest比 +45%(遅い) |
| jest 並列(jestの最速) | 8 × 4 | 312s | 4ワーカーが上限 |
| vitest 並列(最速) | 8 × 6 | 293s | jest直列比 −44% |
4vCPUの直列同士ではvitestが+45%遅く、並列でひっくり返ります。並列化は、この増えた評価コストを複数ワーカーに分散して取り返すのがねらいです。
なお、babel-plugin-lazy-requireを使っていない同レポジトリのサブアプリ(MongoDBだけ使う、テストの少ない小さめのアプリ)は事情が違いました。こちらはそもそも遅延評価に頼っていないので、直列のままでも遅くなりません。むしろ移行だけで速くなりました。4vCPU・4shardの実測で、直列に替えるだけでshard平均が347秒 → 147秒(2.4倍)、さらにshard内をworker2並列にすると114秒(jest直列比3.0倍)まで縮みました。直列で遅くなるのは、遅延評価に頼っていた、モジュール依存グラフの大きい本体アプリ固有の話です。
並列: メモリ差でスケールして勝つ
直列で遅いなら、jestのまま並列化すればいいのでは、と当然考えます。実際にjestの並列化も試しました。結論から言うと、jestは並列にするとメモリが先に尽きて、それ以上ワーカーを増やせませんでした。
同じ8vCPU機(RAM 30GiB)で、jestとvitestのワーカー数を振って実測した結果がこれです。
| ランナー | ワーカー | メモリピーク | 結果 |
|---|---|---|---|
| jest(直列) | 1 | 12.4GiB / 40% | green |
| jest | 4 | 27.4GiB / 89% | green(ここが上限) |
| jest | 6 | 28.8GiB / 94% | OOMで半分近いshardが落ちた |
| vitest | 6 | 12.3GiB / 40% | green |
jestはワーカーごとに子プロセスを立てて、アプリケーションを丸ごとロードします。共有がないので、メモリがワーカー数にほぼ比例して増えます。実際に試した範囲では、8vCPU機でワーカー4が上限でした。6にするとOOM killされて、半分近いshardが落ちます。jestはメモリのほうが先に頭打ちになります。
vitestは1ワーカーあたりの常駐メモリが小さく、6ワーカーでもピークは12.3GiB(全体の40%)で、18GiBほど余っていました。仕組みまでは断定しませんが、jestの子プロセスがアプリを丸ごと抱えるのに比べ、vitestのワーカーが軽いのは確かです。メモリはまだ余っていて、ワーカー数の上限はCPUのほうで決まります。
設定はこうです。pool: 'forks' で fileParallelism を有効にして、shardの中を複数ワーカーで並列に動かします。
// vitest.config.ts(抜粋)
export default defineConfig({
  test: {
    pool: 'forks',
    fileParallelism: true,             // shard内をworker並列にしてimportコストを分散
    maxWorkers: getTestWorkerCount(),  // ランナーのCPUとRAMから自動算出
    // ...
  },
})
ワーカー数はCPUとRAMの両方から決めます。片方だけで決めると、CPUに余裕があってもRAMを超えてカーネルにOOM-killされます。
// __tests__/workerCount.ts
export function getTestWorkerCount(): number {
  const cpuCount = os.availableParallelism?.() ?? os.cpus().length
  const totalGiB = os.totalmem() / 1024 ** 3

  const PER_WORKER_GIB = 4 // 1 workerあたりの総RAM見積り(memory.peak実測から)
  const RESERVE_GIB = 4    // DBコンテナ4つ + OS用に確保

  const byCpu = cpuCount - 2                                  // コンテナ用に2コア空ける
  const byMem = Math.floor((totalGiB - RESERVE_GIB) / PER_WORKER_GIB)

  return Math.max(2, Math.min(byCpu, byMem)) // 小さい方を採用、最低2
}
8vCPU/30GiBだと、byCpu=6・byMem=floor((30-4)/4)=6 で6ワーカーになります。4vCPU/15GiBだとbyCpu=2で2ワーカー。同じ式でjestを回すと、ワーカー1つあたりが使う実メモリが大きいので8vCPUでも4止まりです。同じスペックのインスタンスで6ワーカーまで積めるか、4で止まるか。直列で失った速度は、この並列スケールの差で取り返しました。
Appendix: ほかに検討した選択肢
ほかに検討してやめた案も、判断の記録として残しておきます。候補は2方向で、jestのまま速くする案と、別のランナーに乗り換える案でした。
jestを速くする方向:
- jest-swc(ts-jestをSWCに差し替え): 速くなるどころか重くなりました。SWCに替えるとbabelが外れ、前述の遅延requireが効かなくなります。全モジュールを前もって評価する分、1 specあたりのメモリが164MB → 393MB(2.4倍)に増えました。ただでさえ素のts-jestでも4vCPU・2ワーカーでメモリ使用率が約90%だったので、2.4倍に増えるとOOMで落ちました。
別ランナーに移る方向:
- bun test: 速度だけなら、おそらくvitestより速くなります。ただ、既存のテスト資産との互換がありませんでした。
jest.mock・testcontainers・NestJSのDI・フロントのDOMテストが軒並み噛み合わず、そのままでは動きません。ここまで噛み合わないと、移行コストが高いという以前に、そもそも移行しきれないリスクがあります。
結局、既存のモックやDIをほぼそのまま活かせて、移行のリスクとコストが一番低いvitestに落ち着きました。速さだけならbunのほうが期待できるぶん惜しいのですが、今回は1万件超のテストを壊さず移せる確実性を優先しました。
移行時のハマりポイント
移行は素直には進みませんでした。大きく2種類のハマりがあります。CommonJSからESMへ移ったことによる互換の問題と、テストを並列にしたことで表に出た共有リソースの問題です。
CJS/ESM間の差異
vitestへの移行は、テストランナーを替えるだけでなく、変換まわりをts-jest(内部でbabel)/CommonJSからSWC/ESMに替えることでもありました。ここの互換で一番ハマりました。
前提: esModuleInteropの有効化
順番としては、まず前提の設定を1つ入れてから移行しました。esModuleInterop: trueが必須条件です。オフのままだと、import fs from 'fs'のようなCJSモジュールのdefault importが、ESM/SWCの経路では正しく解決されず(実体がundefinedになるなどして)実行時に壊れます。移行の前提として、専用の準備PRで先にtrueへ切り替えました。
ただ、これは移行のためだけの後ろ向きな変更ではありません。esModuleInterop: falseはもともと古い設定で、放っておいた技術負債でした。TypeScript 7(tsgo、Go製のネイティブ実装)へ移る布石でもあって、どのみち払う必要がありました。vitest移行がそれを前倒しさせただけ、というのが正直なところです。
循環参照
これは、前述のlazy-require(遅延require)を失った直接の副作用です。requireを遅らせることで、モジュール同士の循環参照(AがBを、BがAを参照する)も評価のタイミングがずれて、実質的に成立していました。CommonJSで循環を避ける定番の効き方です。
vitest(ESM)にはこの遅延がなく、静的importの依存グラフを最初にまとめて評価します(先行評価。いわゆるeager import)。すると、それまで遅延で回避できていた循環参照が表に出て、初期化が回らずに初期化前のundefinedを参照して落ちるようになりました。
対処は、テスト側の小細工で覆い隠すのをやめて、本番コード側で循環を断つことです。NestJSならforwardRef、あるいはbarrel(まとめてre-exportするindex)経由をやめて実体を直接importする、といった直し方で解消しました。テストの都合で見えなくなっていた設計上の循環が、移行をきっかけに表に出た、というのが実際のところです。
回避策としてvite-plugin-entry-shakingも検討しました。barrel経由の不要な読み込みを削って、先行評価とbarrel由来の循環を減らすViteプラグインです。ただvi.mockを壊すうえ、効く範囲が限定的だったのでやめました。結局、本番コード側で循環を断つほうが確実でした。
モジュールの二重インスタンス
ビルド済みのCommonJSライブラリを、ESM側から参照したときに起きます。同じライブラリがCJS版とESM版で二重にロードされて、instanceofや内部レジストリ、NestJSのinjection token(注入の識別子)が別物になり、動かなくなります。
分かりやすい例が、あるライブラリをパッケージのルート(@scope/pkg)からと深いパス(@scope/pkg/dist/...)からの両方でimportしていたケースです。Viteがそれぞれをinline展開して、クラスが二重に作られました。NestJSはprovider(注入対象)をinjection token(インジェクショントークン)で識別します。クラスをそのまま注入する場合、このトークンはクラスの参照そのものです。だからクラスが二重にロードされると参照が別物になり、トークンが一致せず依存解決が壊れます。対処は、そのライブラリだけをCJSのエントリにaliasして、nativeなrequireで1インスタンスに寄せることです。
// vitest.config.ts(抜粋): このlibだけCJSエントリにaliasしてexternal(native require)で読む
// ルートimportと深いパスimportでの二重生成を防ぎ、NestJSのinjection tokenを一致させる
const paymentPlatformCjsAlias = {
  find: /^@scope\/some-lib$/,
  replacement: /* package.json の main(CJS)を指す */,
}
// server.deps.external にも登録して inline されないようにする
zodも同じ形でやられました。CJS/ESMの二重ロードでz.discriminatedUnionが壊れました。判別ユニオンの内部でスキーマの同一性を見ているところが、別インスタンス同士で一致しなくなったようです。対処は、vitest.configのalias設定で、zodを常にCommonJS版へ解決するよう固定して、ロードを1系統に寄せることです。
// vitest.config.ts: zod を単一のCommonJSインスタンスに固定する
const zodCjs = createRequire(import.meta.url).resolve('zod')

export default defineConfig({
  test: {
    alias: [
      // bson も CommonJS 版に固定(ObjectId の二重ロード回避)
      { find: /^bson$/, replacement: r('./node_modules/bson/lib/bson.cjs') },
      // zod を常にCommonJS版へ解決する
      { find: /^zod$/, replacement: zodCjs },
    ],
  },
})
zodのように広く使われていて、内部で同一性チェックやシングルトンを持つライブラリは、どれも同じ危険があります。
同じ二重ロードは、MongoDBを使っているならObjectIdでも起こりえます。これはmongodbとbsonの混在が原因です。mongodbは内部でbsonをrequireしていて、本番のCJSではrequireキャッシュのおかげでmongodb.ObjectIdとbson.ObjectIdが同一のクラスでした。ところがvitestでは、同じbsonが「ESM import経由」と「mongodb内部のCJS require経由」で別々にロードされ、ObjectIdが別クラスになります。するとx instanceof ObjectIdやtoEqualが壊れます。
回避策は、vi.mockでbsonのObjectIdをmongodbのObjectIdに寄せて、1クラスに統一することです。
// bson-dedup.vitest.ts: bsonのObjectIdをmongodbのObjectIdに寄せて1クラスに統一
vi.mock('bson', async () => {
  const actual = await vi.importActual<typeof Bson>('bson')
  const mongodb = await vi.importActual<typeof Mongodb>('mongodb')
  return { ...actual, ObjectId: mongodb.ObjectId }
})
SWC由来の落とし穴
TS→JSの変換を、ts-jest(内部でbabel)からSWCに替えたことでもハマりました。vitestの変換はデフォルトだとesbuildですが、本番のAPIサーバに合わせてSWCに差し替えています。
型だけのモジュール(.d.tsしか持たないパッケージ)を値としてimportしていると、SWCが型でないimportを残して実行時に落ちるのも踏みました。import { ValueOf }のような型importはimport typeに直します。本番コードの変更はこの1行だけで済みました。
並列化に伴うインフラ構成
テストを並列にした途端、直列だから成立していた共有リソースの取り合いが一斉に出てきました。フレームワークに依存しない話が多いので、jestを並列化する人にもそのまま当てはまります。
testcontainer(Mongo)のfile descriptor枯渇
複数ワーカーが同じMongoコンテナを叩くと、worker毎に別DBを作る分だけWiredTigerの.wtファイル(collection/index毎)が倍増します。コンテナのデフォルトnofile=1024を超えて、EMFILEからWiredTiger PANIC、mongodがabort(exit 133)してコンテナごと落ちました。全specがECONNREFUSEDで落ちて、最初はメモリ枯渇を疑いましたが、実際はfdの枯渇でした。
対処は、コンテナのfile descriptor上限(nofile)を引き上げて、EMFILEに達しないようにすることです。
new MongoDBContainer('mongo:8.0')
  .withCommand(['mongod', '--replSet', 'myReplicaSet'])
  // fdを引き上げてEMFILE→PANICを回避(メモリではなくfdが原因だった)
  .withUlimits({ nofile: { soft: 1048576, hard: 1048576 } })
  .withReuse()
ワーカーごとのDB分離
同じDBを共有したらテストが互いを壊します。setupFilesの先頭で、DBに接続する前にワーカーID(VITEST_POOL_ID、1からmaxWorkersまで)を使って、ワーカーごとに実体を分けます。MongoはDB名を<db>-w<id>に、PostgreSQL(prisma)は接続URLにschema=worker_<id>を付けて、単一コンテナの上でワーカーごとに独立させます。
// worker-db-namespace.vitest.ts(setupFilesの「先頭」に置く)
// PostgreSQL(prisma)は接続URLにschema=worker_<id>を付けてworker毎に独立スキーマにする
const id = process.env.VITEST_POOL_ID
if (id && process.env.DATABASE_URL) {
  const url = new URL(process.env.DATABASE_URL)
  url.searchParams.set('schema', `worker_${id}`)
  process.env.DATABASE_URL = url.toString()
}
このファイルをsetupFilesの先頭に置くのが必須です。DB接続を張るsetupより後になると、接続時にはまだ元のDB名のままになってしまいます。ESMのimportは巻き上げられるので、同じモジュール内では、接続のimportより先にenvを書き換えることができません。だから接続より先に走る別ファイルに切り出しています。
インデックスができる前にクエリが走る
autoIndexはMongooseの機能で、モデルの初期化時にスキーマ定義のインデックスを自動で張ってくれます。テストでも有効にしています。ただしこれはバックグラウンドで進むので、張り終わる前に.hint()付きのクエリが走ると、hint provided does not correspond to an existing indexで落ちます。直列のフルスイートでは前のspecがindexを張っていて偶然通っていましたが、並列や単体実行では実行順が保証されず、index構築が間に合わないと落ちます。
対処は、beforeAllで全モデルのinit()を待つことです。Mongooseのmodel.init()はそのモデルのindexが張り終わると解決するので、実行順に依存しなくなります。
// vitest.setup.ts(beforeAll): 全モデルのindex構築を待ってからテストを始める
await Promise.all(
  Object.values(mongoose.connection.models).map(model =>
    model.init().catch(() => {
      // 個別のinit失敗は握りつぶし、後続のspecで顕在化させる
    })
  )
)
Prismaマイグレーションの並行デッドロック
Prisma + PostgreSQLの別サービスで、各ワーカーが起動時にprisma migrate deploy(schema=worker_N)を同時に走らせると、DDLがぶつかってdeadlock detected、レスポンスが500エラーになりました。対処は、起動時のマイグレーションを止めて、globalSetupで全workerスキーマを直列に流す経路へ一本化することです。
// setup.ts(globalSetup): worker_1..worker_N を「直列で」pre-migrateする
async function premigrateWorkerSchemas() {
  const baseUrl = process.env.DATABASE_URL
  if (!baseUrl) return
  for (let id = 1; id <= getTestWorkerCount(); id++) {
    const url = new URL(baseUrl)
    url.searchParams.set('schema', `worker_${id}`)
    await execFileAsync('prisma', ['migrate', 'deploy'], {
      env: { ...process.env, DATABASE_URL: url.toString() },
    })
  }
}
その他
このほかにも、自社固有のカレンダーサービス(calendar service)が状態をアカウント単位で持っていて、全ワーカーで共有していたために干渉したケースがありました。一般的な話ではないので詳細は省きますが、対処はDBと同じで、共有している状態をワーカー単位で切るだけです。
エラーと原因の切り分け
ここまでの罠は、どれも並列にして初めて出るたぐいで、直列では絶対に見えません。主に並列化時に起きたエラーと原因を、こう紐づけています。
| ログのシグネチャ | 原因 | 対処 |
|---|---|---|
WiredTiger PANIC(Mongo) |
fd枯渇 | コンテナのnofileを引き上げ |
ECONNREFUSED / MongoServerSelectionError |
Mongoコンテナ自体が落ちた(上の二次症状) | まずコンテナの生死を確認 |
deadlock detected / APIが500エラー(PostgreSQL) |
prisma migrateの並行競合 | globalSetupでpre-migrationに一本化 |
hint ... does not correspond / クエリ結果が実行ごとに変わる |
indexが張られる前にクエリ | beforeAllで全モデルのinit()を待つ |
並列化インフラのコスパ最適化: スポットインスタンスとvCPU·秒
ワーカー数の上限が分かったら、次はrunnerのサイズとshard数をどう組むか、そのコストはいくらか、です。
CIのrunnerはセルフホストのEC2(arm系)で、EC2のスポットインスタンスを使っています。GitHub Actions自体の課金は0で、実コストはEC2の実行時間(秒課金)×レートになります。
料金を語るときに一つ落とし穴があります。スポットインスタンスは時価で、株価みたいに刻々変わります。同じサイズでもインスタンスタイプやアベイラビリティゾーンで倍違うことがあります。だから「スポット単価での最安」を断定すると、翌日には逆転していたりします。オンデマンドにフェイルオーバーした回は、スポットの3倍くらいのコストになることもあります。
そこで、まず投入した計算量そのもの(shard平均 × shard数 × vCPU、以下vCPU·秒)を出し、それにarm系スポットの代表的なvCPU単価(ここでは約$0.028/vCPU時と置く)を一律で掛けて金額に直しました。こうすると構成どうしの比較が、その日のスポットの当たり外れに左右されません。
| 構成 | vCPU | worker | shard数 | shard平均 | vCPU·秒 | $/run(単価一律) |
|---|---|---|---|---|---|---|
| jest 直列(移行前) | 4 | 1 | 12 | 526s | 25,248 | 約$0.20 |
| jest 並列(jestの最速) | 8 | 4 | 12 | 312s | 29,952 | 約$0.23 |
| vitest 並列 | 4 | 2 | 12 | 約480s | 23,040 | 約$0.18 |
| vitest 並列(最速) | 8 | 6 | 12 | 293s | 28,128 | 約$0.22 |
| vitest 並列(採用) | 8 | 6 | 6 | 428s | 20,544 | 約$0.16 |
| vitest 並列(実験) | 16 | 6 | 6 | 354s | 33,984 | 約$0.26 |
金額はvCPU·秒 × 単価で、単価を一律にしているので相場非依存です。採用構成が最小なのは、shard数を12から6に絞って、shardごとの固定費(セットアップ・ビルド・docker pull)を半分にしたからです。実際の請求はそのとき引けたスポット相場で上下します(オンデマンドに落ちれば数倍)。
最終的に採用したのは、8vCPU・ワーカー6で、さらにshard数を絞った構成です。vCPU·秒が20,544で全構成の中で最小になりました。最長時間は最速の293秒より延びますが(428秒)、shardあたりの固定費(セットアップやビルド、docker pull)が減るぶん、計算量では一番安く済みます。速度最優先なら8vCPU×6のshard多め、コスパ最優先なら同じ8vCPU×6のshard少なめ、という切り分けです。
16vCPUは計算量(vCPU·秒)が一番大きいので、単価一律だと約$0.26で全構成中いちばん高くつきます。スポットの実勢価格しだいでは瞬間的にこれが最安になることもありえます。ただ大型はスポットのプールが薄く、そもそも確保に失敗することもそれなりにあります。安く借りられるかは運任せなので、採用をやめました。
テスト以外のボトルネック: 重いジョブの分割とCI全体最適化
テスト自体を速くしても、CI全体で見ると効いてくるのは別のところでした。型チェックとビルドとドキュメント生成をまとめた重いジョブが、1つの中で全部直列に走っていて、これで約1009秒。テストshardの数十秒差が誤差になるくらいで、ここがボトルネックでした。
やったことは単純で、この1ジョブを、互いに依存関係のない2つのジョブに割って並列で走らせました。GitHub Actionsでは、ジョブ間に依存(needs)を張らなければ並列で動きます。
- 静的解析側: lint / 監査 / 型チェック / フロントのテスト
- ビルド側: API doc生成 / スキーマ差分の検証 / 生成したクライアントコードの整合性チェック
さらに、一番長かった型チェックを、API側とフロントエンド側で並列に走らせました(それまでは直列に実行していて、両者の時間が合算になっていました)。
結果はこうなりました。
- 最長時間 1009秒 → 483秒(−52%)。2ジョブが並列なので全体は
max(483, 476)。 - 型チェック単体も378秒 → 298秒。4vCPUでOOMなし。
ジョブを2つに割ると、セットアップが両方で重複するぶん、課金対象のマシン時間(全ジョブの実行秒数の合計)は増えそうに見えます。ただ型チェックの並列化で削れた分が相殺して、合計は1009秒 → 959秒とほぼ横ばいでした。待ち時間を半分にしても、コストはほぼ変わっていません。
まとめ
jestからvitestへ、テスト1,500ファイル・1万件超を移しました。速度・メモリ・料金(vCPU·秒)がどれも下がっています。速くなった要因は、テスト時間の大半を占めるモジュール評価(import)を並列に分散できたことでした。vitestはメモリ効率がよく、jestより多くのワーカーを積めます。
そこまでにハマったのは大きく2つです。1つはCJS→ESM化にともなう互換で、esModuleInteropの有効化、循環参照の解消、CJS/ESM二重ロードの排除。本番コード側を直して対応しました。もう1つは並列化で表に出た共有リソースの取り合いで、testcontainerのfd上限、ワーカーごとのDB分離、Prismaマイグレーションの直列化。共有していた状態をワーカー単位で分けて解決しました。どちらも直列のjestでは見えなかったものです。
esModuleInteropと循環参照の解消は、どのみちいつか返す負債でした。移行のタイミングでまとめて返せた形です。いちばん時間を食ったのもランナーの差し替えではなく、このCJS→ESM化の後始末でした。
採用情報
ミツモアでは、TypeScript をはじめとするモダンな技術スタックでユーザーに価値を届ける仲間を募集中です。
「技術で課題を解くことにワクワクできる人」や「仕組みで社会を良くしたい、そんなエンジニアになりたい人」、ぜひご応募をお待ちしています!
ミツモア採用ページ: https://corp.meetsmore.com/
